
Qwen3.8和DeepSeek价格对比的核心结论:Qwen3.8-max输出36元/百万tokens,DeepSeek V4-Pro高峰输出27元、闲时13.5元,前者比后者高峰贵约33%、比闲时贵约167%。典名词元提供两家模型的统一中转调用,按量计费、价格比官方直购更优惠。如果你正在评估两款旗舰模型的调用成本,下面的计费明细和省钱方法可以直接参考。
Qwen3.8和DeepSeek价格对比:最新价格差距
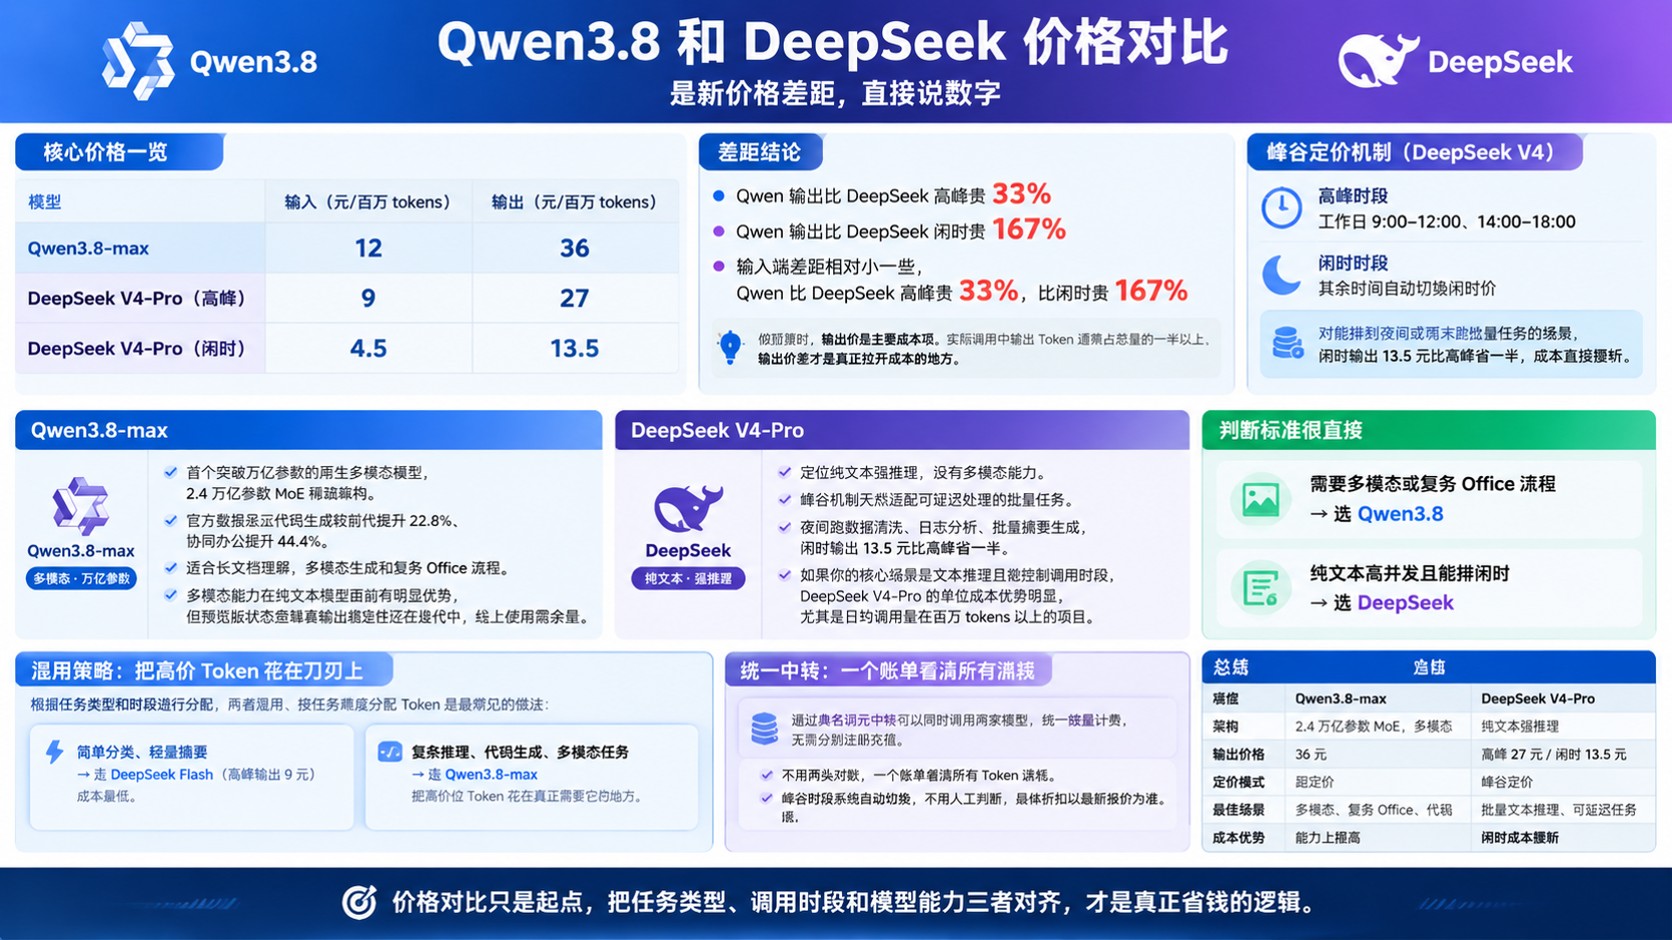
直接说数字:Qwen3.8-max输入12元、输出36元/百万tokens,DeepSeek V4-Pro高峰输入9元、输出27元,闲时输入4.5元、输出13.5元。Qwen输出比DeepSeek高峰贵33%,比闲时贵167%;输入端差距相对小一些。做预算时输出价是主要成本项,因为实际调用中输出Token通常占总量的一半以上,输出价差才是真正拉开成本的地方。
DeepSeek V4是国产旗舰中采用峰谷定价的模型,工作日9:00-12:00和14:00-18:00为高峰,其余时间自动切换闲时价。对能排到夜间或周末跑批量任务的场景,闲时成本直接腰斩。这是Qwen3.8和DeepSeek价格对比中最容易忽略的变量——如果你的业务高峰恰好在工作时段,DeepSeek的实际均价会向Qwen3.8-max靠拢。
通过典名词元中转可以同时调用两家模型,统一按量计费,无需分别注册充值。做Qwen3.8和DeepSeek价格对比时不用两头对账,一个账单看清所有Token消耗,峰谷时段系统自动切换不用人工判断,具体折扣以最新报价为准。
两款旗舰模型的能力边界与适用场景
Qwen3.8-max是阿里首个突破万亿参数的原生多模态模型,2.4万亿参数MoE稀疏架构。官方数据显示代码生成较前代提升22.8%、协同办公提升44.4%,适合长文档理解、多模态生成和复杂Office流程。多模态能力在纯文本模型面前有明显优势,但预览版状态意味着输出稳定性还在迭代中,线上使用需留余量。
DeepSeek V4-Pro定位纯文本强推理,没有多模态能力,但峰谷机制天然适配可延迟处理的批量任务。夜间跑数据清洗、日志分析、批量摘要生成,闲时输出13.5元比高峰省一半。如果你的核心场景是文本推理且能控制调用时段,DeepSeek V4-Pro的单位成本优势明显,尤其是日均调用量在百万tokens以上的项目。
判断标准很直接:需要多模态或复杂Office流程选Qwen3.8,纯文本高并发且能排闲时的选DeepSeek。做Qwen3.8和DeepSeek价格对比时把任务类型和时段都考虑进去,两者混用按任务难度分配Token是最常见的做法——简单分类走DeepSeek Flash(高峰输出9元),复杂推理和代码生成走Qwen3.8-max,把高价位Token花在真正需要它的地方。
Qwen3.8和DeepSeek价格对比:百万Token计费明细
Qwen3.8-max全天统一价:输入12元、输出36元/百万tokens,无峰谷之分,任何时段调用价格一致。预览期曾推日间一折、夜间0.2折限时活动,当前是否延续以及具体折扣幅度,以官网最新报价为准。对预算规划来说,统一价的好处是可预期,不用算时段占比,月度成本波动小。
DeepSeek V4-Pro分峰谷两档:高峰输入9元/输出27元,闲时输入4.5元/输出13.5元;V4-Flash高峰输出9元、闲时半价。缓存命中输入从调价前的0.025元涨至高峰0.3元/闲时0.15元,涨幅达1100%。做Qwen3.8和DeepSeek价格对比时这项必须单独核算,尤其是Agent场景,缓存Token量可以是未命中的几十倍。
单看标价Qwen更贵,但DeepSeek缓存命中价暴涨后,高频重复prompt场景的实际成本需要重新算。如果你的Agent每轮对话都命中缓存(编程Agent很常见,缓存命中占比可达90%以上),DeepSeek的缓存绝对价仍然比Qwen低一个数量级,只是折扣幅度比调价前缩水了不少。
选大模型API中转该看哪几个维度
计费透明度是底线。峰谷价、缓存价、超额价是否全部公开可查,隐藏计费项是最大成本风险。拿到报价单后逐项核对,尤其是缓存命中价和并发超限后的单价,这两项最容易在月度账单里产生意外费用。只看输出价做预算,上线后大概率超支,尤其是Agent和RAG场景。
接入成本和协议兼容直接影响开发排期。OpenAI协议兼容意味着现有代码基本不用改,典名词元支持OpenAI协议、约5分钟完成接入,不需要单独写SDK或适配层。国内BGP直连免代理,对线上业务的延迟和稳定性更友好,不用额外搭代理链路,开发环境到生产环境切换无感。
付款合规和模型覆盖广度决定长期可用性。典名词元支持企业开票,发票一次开齐不用逐家申请。覆盖100+模型意味着后续想加模型或换模型不用换平台,Qwen3.8和DeepSeek价格对比的结论可以直接落地到同一个Key里,不用再做第二次选型和迁移。
官网直购和中转平台购买有什么区别
官网直购需要分别注册各厂商账号、分别充值,峰谷时段自己判断,发票逐家开。做Qwen3.8和DeepSeek价格对比时如果只看单次调用价,会忽略管理成本——多模型组合时你要同时盯两个后台的用量和余额,对账也是两头的,财务审核流程走两遍。模型一多,账号管理本身就是隐性成本。
通过中转平台是一个Key调多模型、统一计费出账,可以按月用量谈阶梯折扣,发票一次开齐。典名词元覆盖100+模型,DeepSeek和通义千问在同一账单里,做Qwen3.8和DeepSeek价格对比时不用切后台,所有消耗在一个地方看,月度复盘时数据也是连贯的。
单次调用成本方面,中转平台通常比官方直购更优惠,具体折扣取决于月用量和协商结果。接入时间上,中转约5分钟 vs 官网注册加实名认证流程。售后响应方面,中转有统一客服入口,技术问题不用分别找不同厂商的工单系统排队,响应路径短。
Qwen3.8和DeepSeek价格对比:怎么买最省预算
DeepSeek批量任务尽量排闲时:闲时输出13.5元仅为高峰27元的50%,夜间跑数据清洗或日志分析直接省一半。如果你的业务高峰恰好集中在工作时段,别按闲时价做预算——实际均价会向高峰靠拢,按高峰价做预算上限、按闲时价做下限是比较稳妥的区间,中间值取决于你的实际调用时段分布。
Qwen3.8-max目前处于预览期,曾推日间一折、夜间0.2折限时活动,关注官网最新活动窗口,具体以官网最新报价为准。通过典名词元按月用量谈阶梯价,用量越大单价越低,比纯按量单次计费更划算。月消耗过千万tokens的项目,折扣空间比轻量用户大不少,值得专门谈一轮。
多模型混用是控成本的核心策略:简单分类和摘要用低价模型(如DeepSeek Flash),复杂推理和代码生成才调旗舰。Qwen3.8和DeepSeek价格对比的结论不只是谁便宜,而是什么任务该用什么价位的模型。把Token预算花在刀刃上,总成本比全走旗舰低一个量级,质量不降反升。
大模型API接入的三个常见坑
坑一:只看标价忽略缓存命中价。DeepSeek缓存命中输入从0.025元涨到0.3元(高峰),涨幅1100%。高频重复prompt的RAG场景成本可能反超预期——一个编程Agent每轮对话都读取代码和历史上下文,缓存Token量可以是未命中Token的几十倍。接入前统计自己的prompt复用率,复用率超80%的项目要单独算缓存成本再定方案。
坑二:把峰谷当固定折扣。目前只有DeepSeek采用峰谷定价,如果业务高峰集中在工作时段,实际调用成本接近Qwen3.8-max的输出价。别按闲时价做预算,做Qwen3.8和DeepSeek价格对比时把高峰时段占比算进去,按实际调用时段加权计算均价才是真实成本,否则月度复盘时你会发现预算和实际对不上。
坑三:拿预览版跑生产。Qwen3.8-max目前是预览版加每日迭代机制,模型能力每天都在变,线上业务需要稳定输出时不宜直接依赖。建议灰度验证一两周,用真实业务prompt跑通后确认输出质量和延迟达标,再全量切换。预览期限时活动窗口有限,关注时机但别为了低价牺牲业务稳定性。
从需求确认到上线的落地流程
第一步需求诊断(约0.5天):明确要调哪些模型、预估月调用量(百万tokens级别)、是否需要多模型切换、有无发票和SLA要求。产出物是一份需求清单,写清模型、量级、合规要求,这一步决定后续报价的精度,需求越清楚报价越准,后期扯皮越少。
第二步方案与报价确认(1天内):选定计费档位、确认折扣比例、对齐发票主体。典名词元提供接入方案与报价单,支持按量付费并可协商阶梯折扣,这一步把价格锁死后续不会被动。第三步接入部署(约5分钟):获取API Key,按OpenAI协议对接,典名词元提供接入指引和调试支持,遇到报错直接找客服就行。
第四步测试验收(1-2天):用真实业务prompt跑通,验证输出质量、延迟和异常处理。第五步正式上线后配置用量告警,按月对账单,用量变化时及时调档。做Qwen3.8和DeepSeek价格对比时积累的用量数据,就是后续调档和谈折扣的核心依据,数据越全谈判越有底。
典名词元能提供哪些大模型API服务
典名词元定位大模型API中转服务,覆盖DeepSeek、GPT、Claude、Gemini、通义千问等100+模型,OpenAI协议兼容、国内BGP直连免代理。做Qwen3.8和DeepSeek价格对比后选定模型,直接在一个Key里调用,不用分别对接不同厂商的接口,开发侧零改造。
计费方式为按量付费,价格比官方更优惠,支持企业开票与SLA保障,约5分钟完成接入。具体折扣取决于月用量规模,用量越大可谈的阶梯空间越大。合作时说明预估月调用量,对方即可给出对应档位的报价方案,不用反复询价。
适合需要多模型统一调用的开发者和中小团队、对Token成本敏感想拿到更优单价的项目、需要合规发票和稳定SLA的企业业务。联系典名词元客服说明模型需求和预估月用量,可谈阶梯折扣和专属技术支持,具体价格以最新报价为准,先要报价单对比再决定。
常见问题
Qwen3.8和DeepSeek价格对比后怎么选才不亏?
看任务类型和时段。需要多模态或复杂Office流程选Qwen3.8-max,纯文本批量且能排闲时选DeepSeek V4-Pro。两者混用按难度分配Token是多数项目的做法,通过典名词元可以一个Key同时调用,统一出账不用两头对账,月度成本一目了然。
DeepSeek闲时价具体怎么算、覆盖哪些时段?
DeepSeek V4-Pro闲时输入4.5元、输出13.5元/百万tokens,高峰输入9元、输出27元。闲时覆盖工作日12:00-14:00、18:00以后以及整个周末。批量任务排到夜间或周末,输出成本直接省50%,这是峰谷定价最直接的省钱方式。
大模型API中转平台怎么判断正规性?
看三点:是否公开全部计费项(峰谷价、缓存价、超额价)、是否支持企业开票、是否有SLA保障。典名词元这几项都具备,接入前可以先要报价单逐项核对,确认无误再正式开通,避免上线后才发现隐藏收费项导致预算失控。
通过中转平台买大模型API能开企业发票吗?
可以。典名词元支持企业开票,多模型消耗在同一账单里,发票一次开齐不用逐家申请。开票主体在合作确认阶段就对齐,后续按月出账按月开票,财务审批流程走一遍就够,比官网逐家开发票省事不少。
Qwen3.8-max预览版能直接上线生产吗?
不建议。Qwen3.8-max目前是预览版加每日迭代机制,模型输出每天都在变,线上业务需要稳定时建议灰度验证一两周再全量切换。预览期限时活动窗口有限,关注时机但别为了低价牺牲业务稳定性,具体活动以官网最新报价为准。
月用量不大时按量付费和包月哪个划算?
月调用量在几百万tokens以下的轻量使用,按量付费更灵活,用多少付多少没有浪费。用量稳定且月消耗过千万tokens时,谈阶梯折扣更划算。典名词元按量付费起步,用量上来后可协商切换计费方式,不用一开始就锁定大额包月。
Qwen3.8和DeepSeek价格对比里缓存命中价怎么影响总成本?
缓存命中输入是Agent场景的隐藏大项。DeepSeek缓存命中从0.025元涨到0.3元(高峰),涨幅1100%,如果prompt复用率超80%,这部分成本会显著上升。接入前统计自己的缓存命中率,别只看输出价做预算,否则月度账单大概率超预期。