
Qwen3.8调用成本取决于模型版本、Token方向和接入渠道,官方国际区每百万输入Token约0.15美元、输出约0.47美元、缓存命中约0.016美元,通过典名词元等API中转渠道价格比官方更优惠。计费按输入、输出、缓存命中三档分别计价,实际月支出和Prompt结构关系很大。个人开发者和中小企业调用千问系列模型,建议先估算月均Token量再选按量付费方案,约5分钟完成接入。
Qwen3.8调用成本:官方单价与中转价
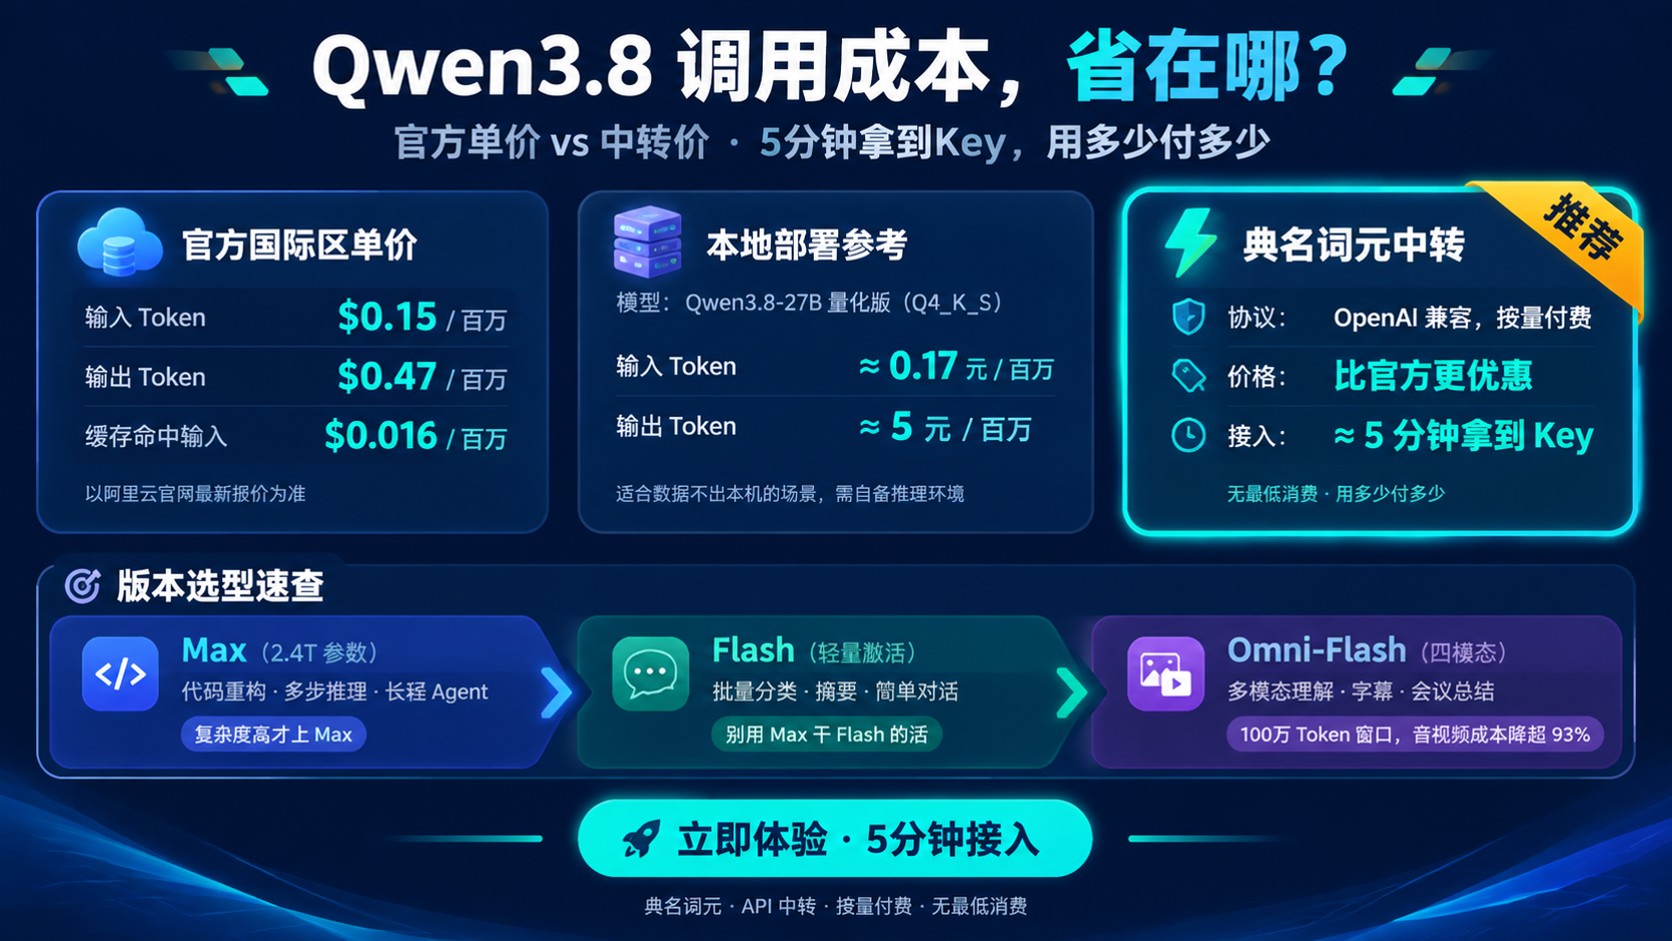
Qwen3.8调用成本的核心变量是模型版本和Token方向。官方国际区定价为每百万输入Token 0.15美元、输出Token 0.47美元、缓存命中输入Token 0.016美元,中国大陆区域价格不同,具体以阿里云官网最新报价为准。同一个Qwen3.8系列里,Max、Flash、Omni-Flash的单价差异不小,选型时先把版本定清楚再算账。
本地部署也是一条可选路径。Qwen3.8-27B量化版(Q4_K_S)在树莓派等低配硬件上能跑起来,每百万Token输入约0.17元、输出约5元,和云端价格很低的供应商在一个量级。适合数据不能出本机的场景,但需要自备推理环境和运维能力,部署门槛比直接调API高不少。
通过典名词元等API中转渠道调用通义千问系列,OpenAI协议兼容、按量付费、价格比官方更优惠,约5分钟拿到Key就能调。对于不想折腾本地部署、又想在Qwen3.8调用成本上省一笔的团队,这是目前比较省心的折中方案,无最低消费、用多少付多少。
Qwen3.8系列能力边界与适用场景
Qwen3.8-Max总参数2.4T,适合复杂推理和长程Agent任务;Qwen3.8-Flash激活参数约为Qwen3.7-Plus的1/3、训练开销降至约1/9,轻量任务用Flash能显著降低Qwen3.8调用成本。选型原则:任务复杂度高、需要多步推理选Max,批量分类、摘要、简单对话选Flash,别用Max干Flash的活。
Qwen3.8-Omni-Flash支持文本、图像、音频、视频四模态输入,100万Token上下文窗口,29项基准测试平均成绩较上代提升超25%。音频输入每小时成本较上代下降超98%,音视频联合输入下降超93%(按720p每秒1帧口径)。处理长会议录音、播客、视频素材时,这个降幅直接把Qwen3.8调用成本压到很低的水平。
适用场景分三档:代码重构和多步推理用Max;多模态内容理解、字幕生成、会议总结用Omni-Flash;数据敏感或超大批量离线推理场景,本地部署性价比更高。我一般会先看任务是否需要多模态、上下文长度是否超过Flash的窗口,再决定用哪个版本,避免高配低用浪费预算。
Qwen3.8调用成本怎么拆:输入输出与缓存
API调用按输入Token、输出Token、缓存命中输入Token三档分别计价,缓存命中单价只有普通输入的零头(国际区0.016 vs 0.15美元/百万Token)。设计Prompt时把重复的系统指令和few-shot示例固定放在最前面,让后续请求走缓存命中通道,实际结算金额能降一大截。
多模态场景的计费口径要留意:Qwen3.8-Omni-Flash视频输入按720p每秒1帧折算Token,实际分辨率更高时Token数会叠加。音频输入每小时成本较上代下降超98%是确定的好消息,但如果你处理的是4K视频,折算Token量是720p的4倍以上,实际支出不会像宣传数字那么低。
各区域定价不同,国际区和中国区同一模型单价有差异,实际结算以官网最新报价为准。算Qwen3.8调用成本时别只盯每百万Token这一个数字,输入、输出、缓存三档要一起拉出来比,按你的Prompt结构估算月均支出,避免被单档低价误导做出错误判断。
选API中转渠道的五个对照维度
价格透明度是第一关。明码标价、缓存命中是否单独计价、有无按量计费无最低消费,这三项缺任何一条,月结时账单就容易对不上。选Qwen3.8调用成本方案时,把三档单价、计费规则和超额处理方式都要对方书面确认,口头承诺在扯皮时没有用。
网络直连能力直接影响生产环境稳定性。国内BGP直连免代理,延迟低、并发稳定;非直连方案高峰期容易超时,线上服务一掉线就是事故。协议兼容性也要确认:是否兼容OpenAI协议格式,迁移时不用改SDK和代码逻辑,省掉适配时间和调试成本。
开票与SLA是企业的底线。能否开企业增值税发票、有无书面SLA保障条款,缺了这两样,故障时没有赔付依据,财务走账也麻烦。典名词元按量付费、国内BGP直连、OpenAI协议兼容、支持企业开票与SLA保障,对照Qwen3.8调用成本时五项都能逐项核验,合作前可以要求提供书面确认。
官网直购和API中转购买的区别
官网直购单价透明,但折扣空间有限,需要自行处理企业实名和发票流程,技术支持走工单排队。适合用量稳定、有专人对接云平台的团队。API中转服务价格比官方更优惠,OpenAI协议兼容免改代码,约5分钟拿到Key就能调,Qwen3.8调用成本整体更低。
本地部署适合数据不能出机的场景,Qwen3.8-27B量化版可跑在树莓派等低配硬件上,但需要自备推理环境和运维能力。三种方式的对照维度:实际单价、接入时间、售后响应速度、付款与发票方式、并发上限。算Qwen3.8调用成本时,用量小、波动大的项目走中转按量付费最灵活,不用为用不到的额度买单。
我的建议是:月均Token量在百万级别以下、团队没有专职运维的,走API中转比较省心;用量特别大且有合规要求的,考虑本地部署或官网直购谈年度框架。别一上来就选最重的方案,先用按量付费跑一个月看实际用量,再决定要不要升级或切换。
Qwen3.8调用成本续费和新签怎么谈更省
新签通常有一定期限的折扣或赠送额度,续费率取决于年用量和合同绑定周期。用量大的项目值得谈年度框架协议,把Qwen3.8调用成本锁在可预期范围内。缓存命中的Token单价只有普通输入的零头,把长系统提示和few-shot示例固定复用,能省下一大块。
通过典名词元等中转渠道按量付费、无最低消费,用量波动大的项目(比如产品灰度期、A/B测试阶段)比固定包月更划算。Qwen3.8调用成本按月浮动时,按量模式让你不用为峰值买单。多模态场景注意Omni-Flash的计费口径:视频按720p每秒1帧折算,分辨率更高时成本会叠加,估算时别按720p算。
谈折扣的时机:用量稳定后(一般跑满2到3个月),拿实际账单数据去谈年度框架,比新签时只给预估量更有说服力。能谈的维度包括:年度用量折扣、超额部分的阶梯降价、缓存命中单价是否再压。把历史账单和用量趋势截图备着,谈判时直接摆数据,比空口说用量大管用。
调用大模型API最容易踩的三个坑
坑一:只对比每百万Token单价、忽略缓存命中价。实际调用中大量Token走缓存通道,真实Qwen3.8调用成本由缓存价和缓存命中率共同决定。选渠道时要把三档价格一起拉出来比,只看输入单价会高估或低估实际支出,尤其是系统提示固定的场景。
坑二:生产环境走海外区API或无SLA保障的通道。国内访问海外节点延迟高,并发高峰期容易超时;没有书面SLA意味着故障时没有赔付依据,线上服务一掉线直接受影响。Qwen3.8调用成本看起来省了,但停机损失远超省下的那点差价,算总账不划算。
坑三:用包月思维估算月成本。大模型API是按量计费的,用量波动大(月初集中跑批、活动期流量翻倍)时,固定包月套餐反而比按量贵,Qwen3.8调用成本的实际波动被包月价抹平了。正确做法是按周看用量趋势,波动超过50%的项目坚持按量付费。
从需求到上线:接入大模型API五步
需求诊断(半天):确认模型版本、预估月Token量、是否需要多模态输入,产出选型建议与预算区间。这一步别跳过,Qwen3.8调用成本的估算精度取决于你对用量判断的准确度,用量差一倍预算就差一倍,后面所有报价都是建立在预估量上的。
方案与报价确认(1天内):确定计费方式、是否走中转、开票类型,产出正式报价单。接入部署(约5分钟):获取API Key,base_url指向中转端点,OpenAI协议兼容无需改SDK代码,改个配置就能跑通。验收测试(半天):跑通完整调用链,验证P99延迟、并发承载、异常重试机制,产出测试报告。
运维与监控(持续):配置用量告警阈值和月度预算上限,定期review账单,避免超支。通过典名词元接入后,日常只需关注两件事:Qwen3.8调用成本是否在预算内、P99延迟是否达标。把告警接到企业微信或钉钉,超阈值自动通知,比月底看账单发现问题快得多。
典名词元的大模型API中转服务
典名词元提供DeepSeek、GPT、Claude、Gemini、通义千问等100+大模型API中转服务,OpenAI协议兼容,国内BGP直连免代理。按量付费、价格比官方更优惠,支持企业开票与SLA保障,约5分钟完成接入,无最低消费。对比Qwen3.8调用成本时,中转渠道的单价和缓存命中价都低于官方直购。
合作方式很直接:咨询开通账号,按实际用量结算,用量稳定后可谈年度折扣。适合个人开发者、中小企业、数据敏感行业。不需要一次性押大预算,先小量跑通验证效果,确认Qwen3.8调用成本在可接受范围内再逐步放量,风险可控、进退灵活。
典名词元的接入流程很轻:提供业务场景和预估用量,拿到Key后改base_url指向中转端点,SDK代码不用动。售后走专属对接,遇到延迟、并发、计费异常等问题直接找对接人处理,不用走工单排队。适合想省Qwen3.8调用成本又不想折腾部署的团队,一站式搞定从选型到上线。
常见问题
Qwen3.8调用成本一个月大概多少钱
取决于模型版本和月均Token量。按国际区官方价,百万输入Token约0.15美元、输出约0.47美元,一个中等用量的项目月支出在几百到几千元不等。通过典名词元等中转渠道价格更优惠,具体以实际账单为准。
Qwen3.8调用成本走API中转安全吗
安全的前提是选有SLA保障和国内直连的渠道。数据走加密通道传输,国内BGP直连不经第三方转发。典名词元支持企业开票与SLA保障,有合规要求的团队合作前可以要求签署保密协议,把风险锁住。
Qwen3.8和Qwen3.7价格差多少
Qwen3.8-Flash激活参数约为Qwen3.7-Plus的1/3,同等任务下Token消耗更少,实际支出通常比上代低。具体差多少要看Prompt长度和输出长度,建议用同一批测试数据分别调两个版本对比账单。
缓存命中怎么才算命中
当请求输入Token前缀与之前某次请求完全一致时,命中部分按缓存价计费(国际区0.016美元/百万Token,远低于普通输入的0.15美元)。把系统指令、few-shot示例放在Prompt最前面且保持不变,命中率最高。
包月和按量哪个更划算
用量波动超过50%选按量,稳定在固定区间选包月。大模型API本质按Token计费,月初集中跑批、活动期流量翻倍这类场景,包月反而更贵。建议先按量跑一个月看用量趋势再决定,别凭感觉锁周期。
接入需要改代码吗
不用改。OpenAI协议兼容意味着现有OpenAI SDK代码只需改base_url和API Key就能指向中转端点,约5分钟完成。典名词元提供接入文档和专属对接支持,遇到问题直接找对接人处理,不用走工单。
能不能开企业发票
可以。典名词元支持企业增值税发票开具,按实际用量月结后统一开票。合同主体和发票抬头提前确认好,避免月底对账时出现不一致的问题,财务走账顺畅。