
Qwen3.8贵不贵取决于用量:月调用量不大时API按量付费成本可控,高频或隐私敏感场景下3万元硬件跑本地27B更划算。典名词元提供通义千问等100+模型API中转,OpenAI协议兼容、国内BGP直连免代理,按量付费价格比官方更优惠。先估月Token消耗再对比两条路总成本即可判断。
Qwen3.8贵不贵:看用量和预算
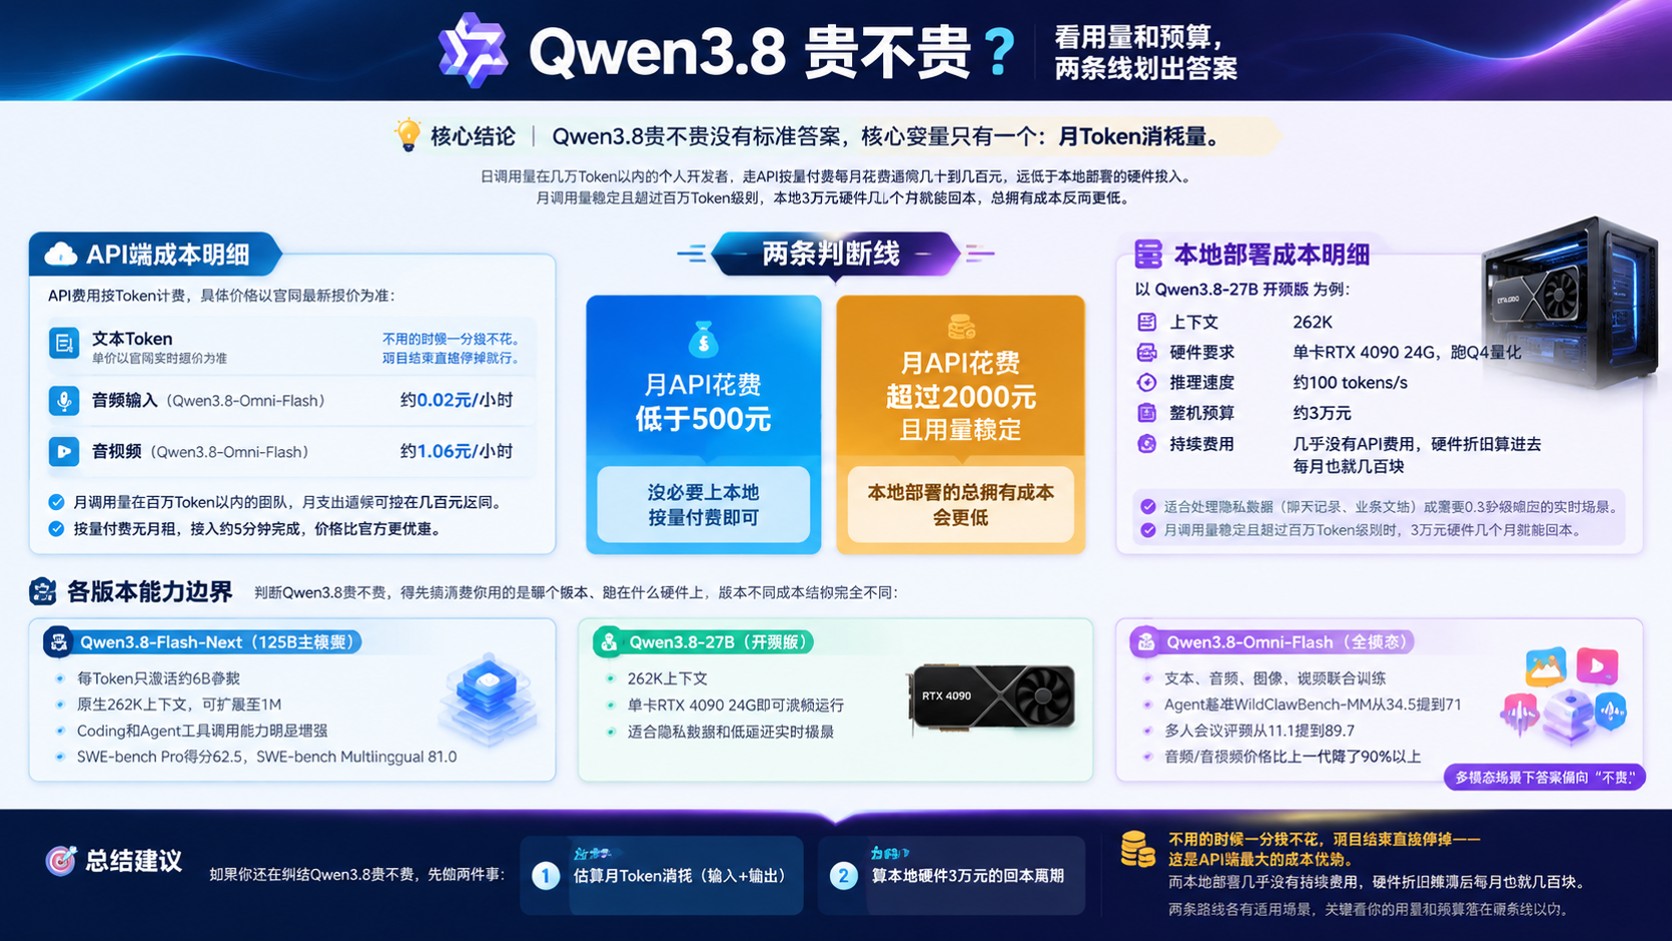
结论是:Qwen3.8贵不贵没有标准答案,核心变量是月Token消耗量。日调用量在几万Token以内的个人开发者,走API按量付费每月花费通常几十到几百元,远低于本地部署的硬件投入。月调用量稳定且超过百万Token级别,本地3万元硬件几个月就能回本,总拥有成本反而更低。
我建议先做两件事:一是估算月Token消耗(输入+输出),二是算本地硬件3万元的回本周期。如果月API花费低于500元,没必要上本地;如果月花费超过2000元且用量稳定,本地部署的总拥有成本会更低。这两条线划出来,Qwen3.8贵不贵就有答案了。
通过典名词元购买API服务,按量付费无月租,OpenAI协议兼容一套接口调100+模型,国内BGP直连免代理,约5分钟完成接入,价格比官方更优惠。Qwen3.8贵不贵的顾虑在成本端可以打消,因为不用的时候一分钱不花,项目结束直接停掉就行。
Qwen3.8系列能力边界与适用场景
Qwen3.8-Flash-Next是125B主模型,每Token只激活约6B参数,原生262K上下文可扩展至1M,Coding和Agent工具调用能力明显增强。SWE-bench Pro得分62.5、SWE-bench Multilingual 81.0。判断Qwen3.8贵不贵,得先搞清楚你用的是哪个版本、跑在什么硬件上,版本不同成本结构完全不同。
Qwen3.8-27B开源版262K上下文,单卡RTX 4090 24G跑Q4量化约100 tokens/s,3万元整机预算即可在个人电脑上流畅运行。适合处理隐私数据(聊天记录、业务文档)或需要0.3秒级响应的实时场景。从这个角度看Qwen3.8贵不贵,本地部署几乎没有持续API费用,硬件折旧算进去每月也就几百块。
Qwen3.8-Omni-Flash走全模态路线,文本、音频、图像、视频联合训练,Agent基准WildClawBench-MM从34.5提到71,多人会议评测从11.1提到89.7。音频输入约0.02元/小时、音视频约1.06元/小时,比上一代价格降了90%以上。Qwen3.8贵不贵在多模态场景下答案偏向不贵,Qwen3.8贵不贵的顾虑在这个版本基本可以放下。
Qwen3.8贵不贵的价格明细:API与本地部署
API端费用按Token计费,Qwen3.8-Omni-Flash音频输入约0.02元/小时、音视频约1.06元/小时(云栖发布价),文本Token单价以官网最新报价为准。月调用量在百万Token以内的团队,月花费通常在几十到几百元区间,用多少付多少、无月租,闲时不产生任何费用。
本地部署端一次性投入约3万元:RTX 4090 24G显卡约1.5万、128G DDR5内存约7千、外设和机箱若干。无持续API费用,但承担电费(单卡满载约450W,每月电费约100-200元)和硬件折旧。Qwen3.8贵不贵算总账时,本地部署首年总成本约3.2-3.4万元,之后逐年递减只剩电费和维护时间。
分项拆解来看:API成本=输入Token单价×调用量+输出Token单价×调用量,用量越大绝对值越高但单价不变;本地成本=硬件一次性投入+月电费+模型更新维护的时间成本。判断Qwen3.8贵不贵到底选哪条路,把两条路的月均成本画到同一张表上对比最直观,Qwen3.8贵不贵的答案就出来了。
选API还是本地部署的五个对照维度
月调用量与Token消耗是最核心的对照维度。日调用量稳定且大(比如日均超过50万Token),本地3万硬件几个月可回本;用量波动大、有峰值有低谷的,API按量付费更灵活,闲时不产生费用。判断Qwen3.8贵不贵,用量是第一个要算清楚的变量,也是后续所有对比的基准。
数据隐私要求决定你能不能用云端。敏感数据(聊天记录、业务代码、客户信息)本地处理不出内网,云端API需评估数据合规风险。并发与响应方面,本地单卡100 tokens/s有上限,高并发场景会排队;云端API弹性并发无瓶颈。Qwen3.8贵不贵在这个维度上要看具体场景:高并发选API、隐私敏感选本地,Qwen3.8贵不贵的答案按场景分配比二选一更实际。
运维成本容易被低估。本地部署需自己装推理框架、跟版本更新、处理显存溢出和量化精度问题;API中转(如典名词元)接入约5分钟、无需维护GPU、OpenAI协议兼容一套接口全打通。接入复杂度和售后也是维度:API中转支持企业开票和SLA,本地出问题只能自己排查。Qwen3.8贵不贵的隐性成本在运维这块最明显,本地部署的所谓免费其实是拿时间换的。
官方直购与API中转渠道费用对比
官方直购价格公开透明,需注册对应云平台账号,付款走官方渠道,售后走工单系统,响应时间视工单优先级而定。适合用量大、需要深度定制或已有云平台生态的企业。Qwen3.8贵不贵在官方渠道,单价最透明,但从注册到跑通测试通常要1-2天,接入流程相对长。
API中转渠道(如典名词元)OpenAI协议兼容一套接口调100+模型,国内BGP直连免代理,价格比官方更优惠,支持企业开票与SLA保障,约5分钟完成接入。本地部署首年成本约3万硬件+电费,无API账单,但模型升级需手动换权重、调参数。Qwen3.8贵不贵在长期维护上,本地部署的隐性时间成本不能忽略。
对照口径建议看四项:首年总花费、接入耗时、发票类型、故障响应方式。官方直购首年=API调用费;API中转首年=调用费(可能比官方低);本地首年=硬件3万+电费。Qwen3.8贵不贵的最终判断,要把接入耗时和售后响应也算进总成本里。如果团队没有专职运维,Qwen3.8贵不贵的答案更倾向API渠道,具体以官网最新报价和签约条款为准。
按量付费怎么算最省钱
按量付费的核心逻辑是用多少付多少、无月租,闲时不产生任何费用,适合项目制或流量波动大的团队。月调用量在几十万Token的团队,月花费可能只有几十块;用量突然翻倍时成本线性增长,不会出现硬件闲置浪费。Qwen3.8贵不贵在低用量场景下,按量付费是最省的选择,因为不用的时候一分钱不花。
批量与长期合作能进一步压低单价。通过典名词元等API中转渠道可谈阶梯用量价,月消耗越大单价越低。混合策略最稳:日常轻量调用走API按量,隐私或高频固定任务走本地27B,两条腿分摊成本。Qwen3.8贵不贵的省钱思路是把预算按场景分出去,该用API的用API、该跑本地的跑本地。
新签与续费的区别:API中转按量付费无新签/续费之分,随时开随时停;本地部署无续费但需关注模型版本迭代节奏,Qwen迭代快,关注官方release。如果月用量稳定且持续超过半年,本地3万硬件的回本周期大约6-12个月。Qwen3.8贵不贵算长期账,要看你打算用多久、用量会不会变,Qwen3.8贵不贵的答案随时间推移会变化。
Qwen3.8贵不贵的三个常见坑
上下文长度陷阱:1M上下文不等于全塞。把整个代码库丢进去Token消耗暴增、费用翻几倍,Qwen3.8贵不贵的账单瞬间从不贵变成很贵。正确做法是先截断到必要片段再调,配合代码检索和知识库做上下文管理,把实际输入的Token控制在合理范围,别为用不上的上下文付费。
本地量化精度损失:Q4量化跑27B速度快但复杂多步推理精度会下降,上线前必须跑自己业务的基准测试对比全精度输出。如果业务对推理准确性要求高(比如金融、医疗),Qwen3.8贵不贵的判断要加上精度够不够用这个前提,不够用就得用更高精度量化或上更大显存,成本会相应增加。
API渠道合规与售后真空:选无SLA、不开票、无国内节点的小渠道,掉线或计费争议找不到人,Qwen3.8贵不贵的便宜可能是最贵的。选支持企业开票和明确SLA的渠道(如典名词元)可规避这类风险,国内BGP直连免代理也减少了网络层故障概率,出问题有明确对接人。
从需求确认到上线的五步流程
第一步需求诊断(0.5天):明确调用场景、预估月Token量、数据敏感度,产出《选型建议书》。这步决定了Qwen3.8贵不贵的答案方向——用量大且隐私敏感走本地,用量小或波动大选API。Qwen3.8贵不贵的判断在这个阶段就要定下来,后面所有投入都跟着这个结论走。
第二步方案确认(0.5天):定API或本地、确认模型版本与配额,双方签字确认配置单。第三步环境部署或接口对接(0.5-1天):本地装推理框架+量化模型,API中转注册密钥+SDK联调,产出可调用接口。通过典名词元走API路径的话,约5分钟就能完成密钥配置和首次调用,接入成本降到最低。
第四步测试验收(1天):跑业务基准、压测并发、抽检输出质量,产出《验收报告》。第五步上线与持续运维:配监控告警、建立模型版本更新节奏。Qwen3.8贵不贵不只是初始采购成本,后续模型迭代和运维也是长期支出。关注Qwen官方release节奏、预留升级窗口,Qwen3.8贵不贵的总账要算全生命周期。
典名词元:大模型API中转服务
典名词元提供DeepSeek、GPT、Claude、Gemini、通义千问等100+大模型API中转服务,OpenAI协议兼容一套接口全打通,国内BGP直连免代理。覆盖文本生成、多模态、Agent工具调用等场景,约5分钟完成接入。Qwen3.8贵不贵的答案,走API中转渠道通常比官方直购更省,价格比官方更优惠,Qwen3.8贵不贵的顾虑在成本端基本可以打消。
合作与计费方式:按量付费、无月租,支持企业开票与SLA保障。可谈阶梯用量价与专属配额,月消耗越大单价越低。具体价格以官网最新报价为准,Qwen3.8贵不贵的最终数字要看你的用量档位和合约周期。通过典名词元咨询可获得针对你用量方案的报价和接入支持。
适合谁:不想自建GPU集群、需要国内直连多模型API、要求快速上线和稳定售后的开发者与企业团队。如果月调用量在百万Token以内、团队没有专职运维,Qwen3.8贵不贵走API中转是性价比更高的选择。咨询方式:访问典名词元官网或联系在线客服,说明用量场景和模型需求,即可获取方案和报价。
常见问题
Qwen3.8贵不贵,一个月大概花多少钱?
取决于用量。月调用量在百万Token以内,API按量付费通常几十到几百元;月调用量超过500万Token且稳定,本地3万硬件6-12个月可回本。Qwen3.8贵不贵没有固定数字,先估月Token消耗再对比两条路总成本。
Qwen3.8 API怎么接入,需要多久?
通过典名词元等API中转渠道,OpenAI协议兼容,约5分钟完成密钥配置和首次调用。国内BGP直连免代理,不需要额外网络配置。注册账号、获取API Key、用SDK发第一个请求即可跑通。
本地部署Qwen3.8需要什么配置?
27B模型Q4量化需要RTX 4090 24G显卡(约1.5万)+128G DDR5内存(约7千),整机约3万元。跑起来约100 tokens/s,适合个人电脑本地推理,无持续API费用但承担电费和硬件折旧。
Qwen3.8贵不贵,走API中转和官方直购差多少?
API中转价格比官方更优惠,具体差额以官网最新报价为准。差异来自渠道批量采购和阶梯用量价,月消耗越大差距越明显。Qwen3.8贵不贵的最终数字取决于你的用量档位,两者都支持企业开票与SLA保障。
Qwen3.8支持企业开票吗?
通过典名词元购买支持企业开票,按量付费无月租,SLA保障明确。官方直购也支持开票,走云平台对公账户。两种方式都是正规渠道,选择时看你的财务流程和发票类型需求。
Qwen3.8适合什么样的团队用?
月调用量在百万Token以内、没有专职运维、需要快速上线的团队适合走API按量付费。数据敏感或日均调用量超过500万Token的团队适合本地部署27B。混合策略(日常走API、隐私任务走本地)适合大多数中型团队。